飲食データ分析事例|「経験と勘」から脱却するBigQuery ML客数予測モデル
10秒でわかる:今回のプロジェクトの全貌
- 課題:店舗ごとの「前年同曜日参照」や店長の経験・勘に頼った客数予測では、連休のズレや過去ノイズを吸収できず、「フードロス」と「過剰・不足人件費」が発生していた。
- 解決策:外食需要の動機(利用シーン・オケージョン)を再定義した上で、前年同曜日と同日・直近12週のトレンド・立地属性・天候・販促フラグなど多角的な要素を融合させたBigQuery ML(勾配ブースティング決定木回帰)モデルを構築。
- 結果:決定係数 R² ≈ 0.86(誤差わずか約17人)の高精度を達成。将来90日間の「晴れ/雨シナリオ」予測をLooker Studioで可視化し、自然増ベースラインに対する販促の「真の純増効果(リフト値)」を定量化する基盤を実現した。
はじめに
飲食業におけるデータ活用の歴史は今、「実績の可視化」から「未来の予測」への転換期を迎えています。
接客や調理といった店舗オペレーションは、元来定量的な把握や構造化が極めて困難な領域です。その中にあって、日々の客数や売上はかねてより日報等を通じて定量化され、食材の発注やワークスケジュール(シフト)を組むための予測業務として店舗運営に組み込まれてきました。
近年、POSデータや店舗管理システム、クラウドDWHの普及により、「過去に何が起きたか」を集計・分析するアナリティクス環境は飛躍的に進化しました。しかし、最も重要な「明日・来週に何が起きるか」という予測領域においては、いまだに現場店長の『経験と勘』、あるいは『前年同曜日の数値を参照する』といった属人的かつ単純なルールベースの運用に留まっているのが実情です。
この「予測の曖昧さ」こそが、飲食経営における2大コスト課題であるフードロス(食材廃棄)と人件費(過剰・不足シフト)を発生させる根本原因であり、ひいては中長期的な経営計画の精度を揺るがす大きな要因となっています。
幸いにも、近年のクラウド基盤やAI・ML(機械学習)技術の発展により、従来は膨大な投資が必要だった高度な時系列予測モデルやアルゴリズムを、極めて実用的かつスピーディにビジネスへ組み込める環境が整いました。
本記事では、ファストカジュアルチェーン(30店舗超)の実データをベースに、単なるツールの導入にとどまらないデータ構造の解釈とドメイン知識を反映した特徴量エンジニアリングによって、決定係数 R² ≈ 0.86(1日あたりの予測誤差わずか17人)を達成した高精度客数予測モデルの構築プロセスを詳しく解説します。
第1章:なぜ「前年同曜日」では限界があるのか?
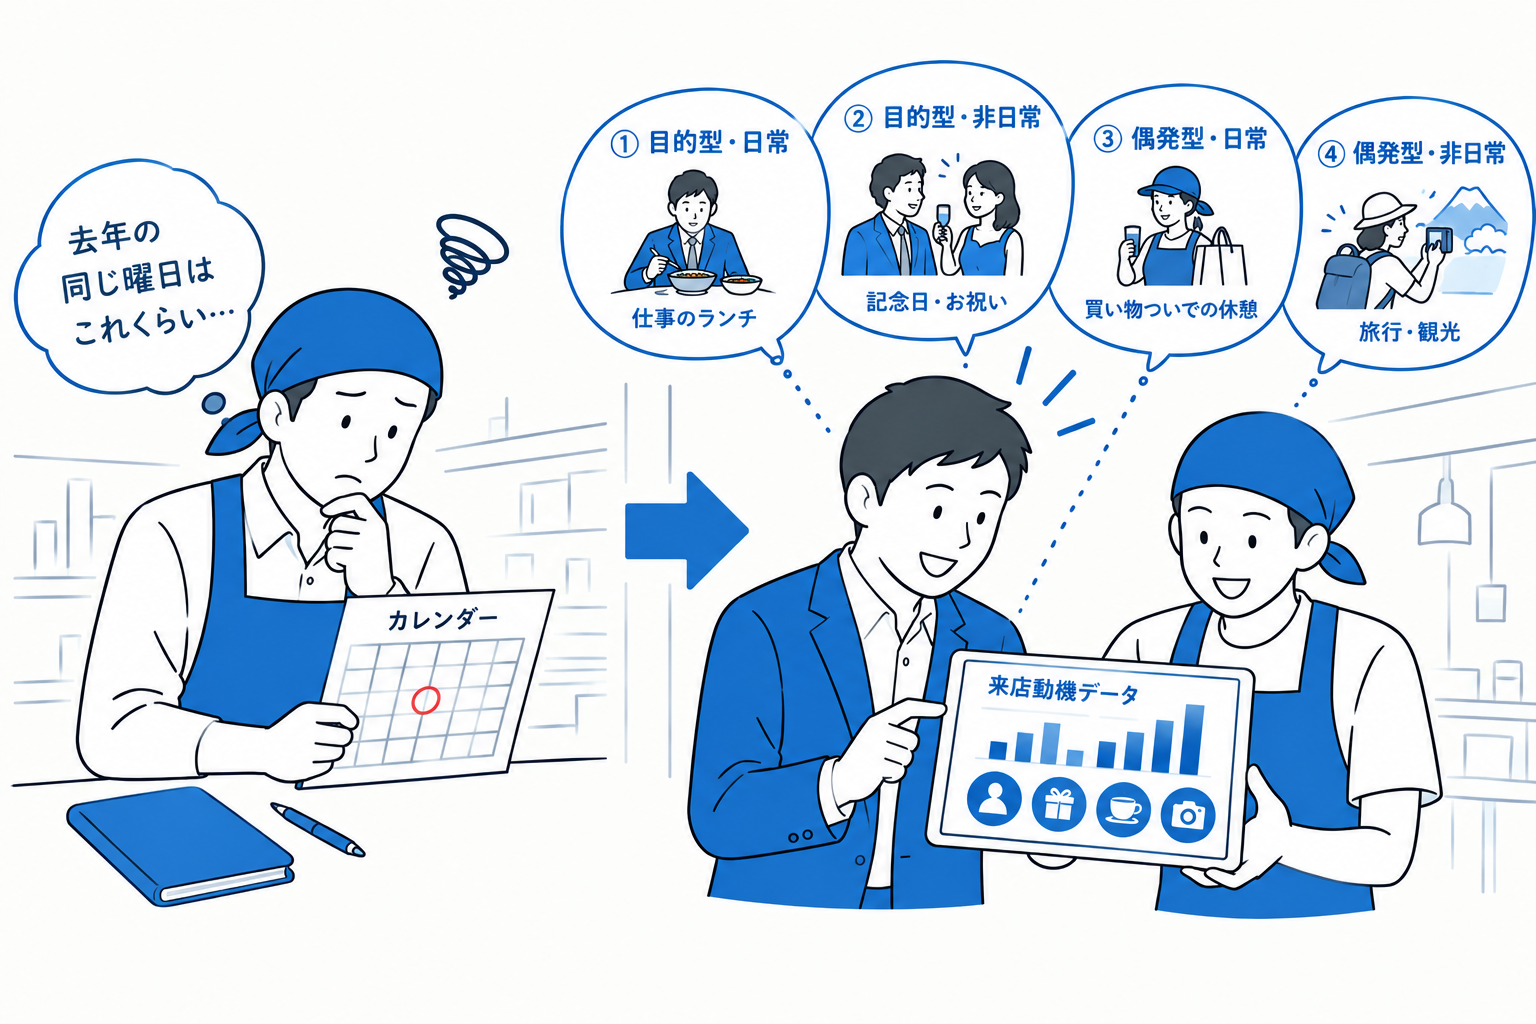
多くの飲食チェーンにおいて、長年「翌週や翌月の予測」の標準的なルールとして採用されてきたのが「前年同曜日の実績を参照する」という手法です。非常にシンプルで一見理にかなっているように思えますが、データサイエンスの視点から見ると、この運用には精度の破綻を招く構造的な5つの限界が存在します。
1. 「前年同曜日参照」が抱える5つの構造的限界
- ① 新規店舗の予測不能(コールドスタート問題): オープンから12ヶ月が経過していない新店には、参照すべき「前年のデータ」そのものが存在しません。多店舗展開を進める成長フェーズの飲食チェーンにおいて、最も慎重なコストコントロールが求められる新店オープン初期に予測モデルが機能しないという致命的な課題が生じます。
- ② カレンダー要因(大型連休・年末年始)のズレ: 5月のゴールデンウィーク、8月のお盆、9月のシルバーウィーク、そして年末年始などの大型連休は、年によって曜日配列が異なります。「前年の3月第2金曜日」と「今年の3月第2金曜日」では条件が近くても、連休前後の1日は「祝日に挟まれた平日」になるか「通常の平日」になるかで客数が激変します。単純な同曜日参照では、こうしたカレンダー効果(Calendar Effects)を吸収しきれません。
- ③ 過去ノイズ(荒天・時短営業)のそのままの伝播: 「前年同曜日」がたまたま台風や豪雨などの荒天だったり、設備トラブルによる臨時の営業時間短縮が発生していた場合、その日は極端に低い実績値として記録されています。前年実績をそのまま参照すると、過去の突発的な異常値が今年の予測にノイズとしてそのまま波及してしまいます。
- ④ ノイズ除外にかかる膨大な運用コスト: 過去ノイズの影響を防ぐには「前年の荒天日や時短日をデータから除外する」作業が必要ですが、現場に当時の天候や臨休の正確な記録が残っているケースは稀です。仮に記録が存在したとしても、全店舗の日次データから手作業でノイズを洗い出し補正する作業には膨大な工数がかかり、実務上の運用限界を迎えます。
- ⑤ 前年の「特異な好不振」による予測バイアス: 前年同曜日に「近隣で大規模イベントが開催されて記録的な売上となった」あるいは「近隣工事や競合オープンにより極度の不振だった」場合、今年の予測には強いバイアス(偏り)がかかります。前年が不振であれば今年の予測は過小評価(仕込み不足・人員不足)となり、前年が極端な好調であれば過大評価(フードロス・人件費高騰)を引き起こします。
2. 需要構造の再定義:利用シーン(オケージョン)による4つの類型化
こうした「前年実績への過度な依存」から脱却し、真に堅牢な予測モデルを構築するためには、単に過去の数字を追いかけるのではなく顧客がなぜ来店するのかという本質的な需要構造(利用シーン=オケージョン)を解き明かす必要があります。
店舗の立地や業態によって客数の変動要因は全く異なります。外食における来店動機は、大きく以下の4つのオケージョンに類型化できます。
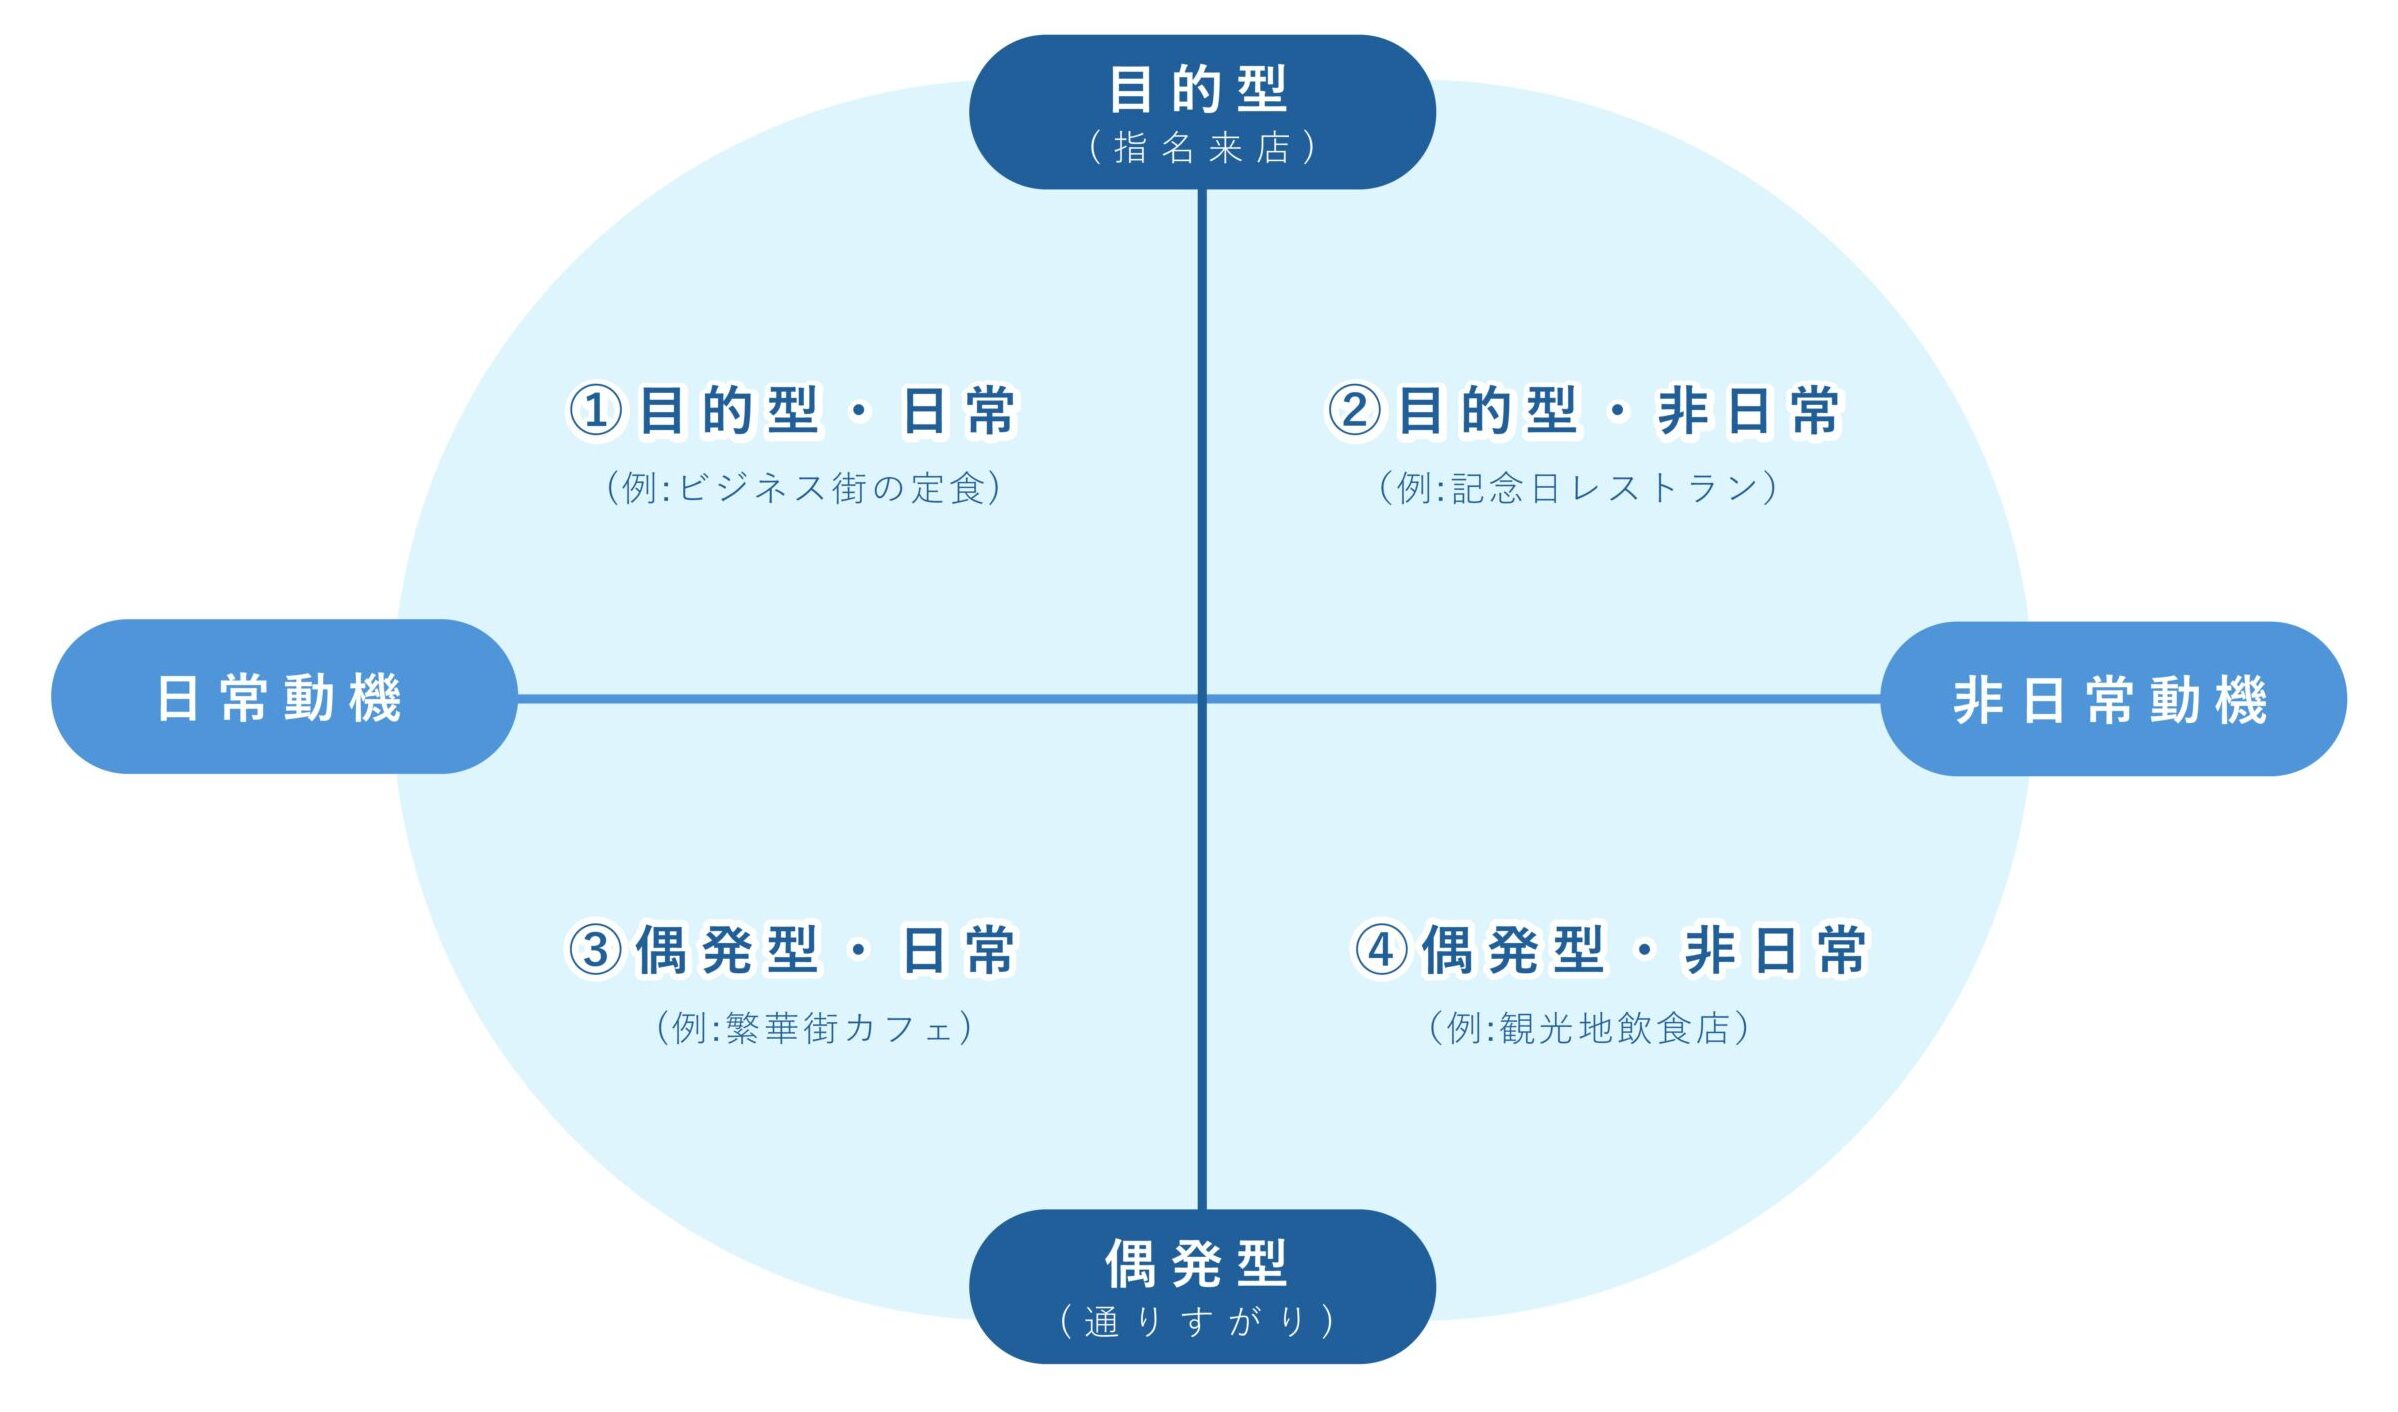
- ① 目的型・日常(デイリー・ルーティン):
- 該当業態:ビジネス街の定食屋、ファストフード、ファストカジュアル(今回の検証対象)など
- 顧客動機:「手早く食事を済ませたい」「日常的なランチ・夕食」
- 変動パターン:曜日や給料日(25日前後)などのカレンダー周期に強く連動します。目的意識が高いため天候悪化(雨)による落ち込みは局所的であり、過去の曜日別傾向(自己回帰性)から極めて安定して予測可能なカテゴリです。
- ② 目的型・非日常(ハレの日・イベント): 高級レストラン、記念日向け店舗など。予約主体のため週末やイベントに連動し、当日の天候悪化を受けにくい特徴があります。
- ③ 偶発型・日常(インパルス・休憩): 繁華街カフェや軽食など。通行量に依存するため、突発的な降雨による雨宿り需要などで急増します。
- ④ 偶発型・非日常(観光・レジャー): 観光地の飲食店など。マクロな季節波動や大型連休に大きく依存します。
3. 初期モデルのターゲット選定
今回のプロジェクトでは、機械学習モデルの精度と有用性を最もクリアに証明するため、まずは「① 目的型・日常」に属する日常利用型ファストカジュアルチェーン(30店舗超)をPoC(概念実証)のターゲットとして選定しました。
この業態は滞在時間が短く回転率が高いため、満席による離脱(機会ロス)が少なく、POSレジの客数データが「真の来店需要」をストレートに反映しています。ノイズが少なく素直な需要データから着手することで、カレンダーや曜日傾向を機械学習がどのように学習し、「前年同曜日参照」を超える精度を叩き出すのかを明確に検証することが可能となります。
第2章:モデル構築のアプローチ(特徴量設計とアルゴリズム選定)
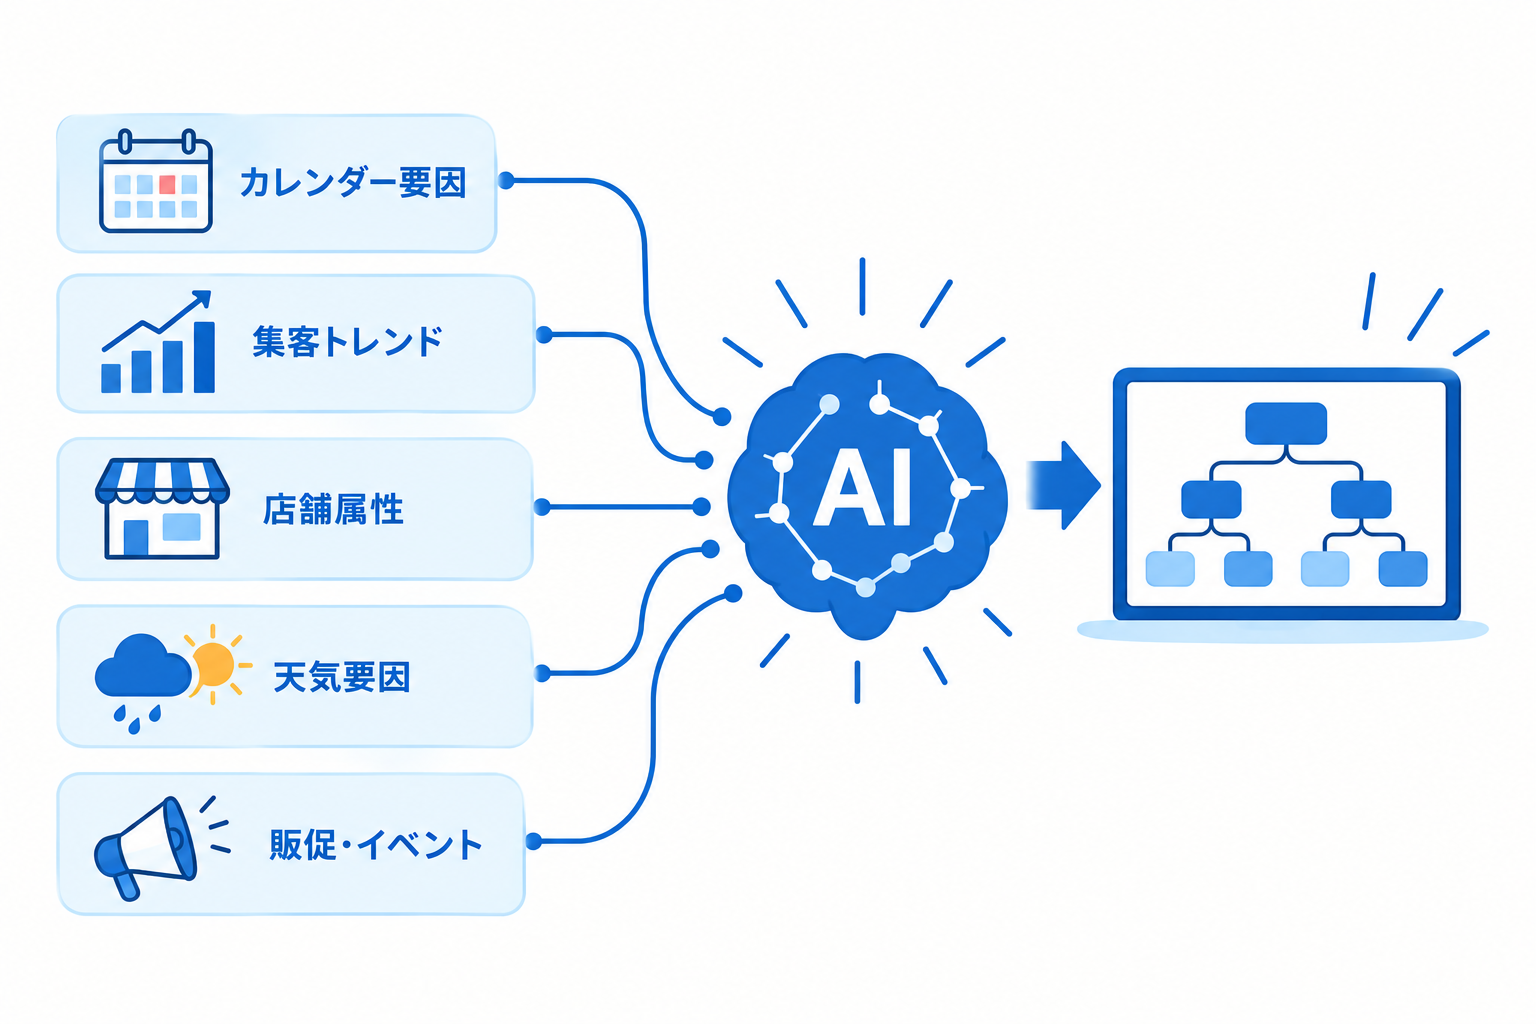
「前年同曜日参照」の限界を克服し、高精度かつ持続可能な予測システムを構築するためには、単にアルゴリズムにデータを流し込むのではなく、「どのような特徴量をモデルに与えるか(特徴量エンジニアリング)」と「業務要件に適合し、説明性の高いアルゴリズムをどう選ぶか」という2つの設計思想が不可欠です。
1. 「目的型・日常」のオケージョンに最適化した特徴量設計
第1章で定義した「目的型・日常」の需要特性を踏まえ、機械学習モデルが日々の変動パターンと中長期のトレンドの双方を正しく把握できるよう、4つの系統から特徴量(説明変数)を設計・投入しました。
- ① カレンダー要因(高度な曜日・祝日構造化): 単純な月〜日の7区分だけでなく、平日・休前日・休日を分類する曜日カテゴリや、GW・お盆・年末年始等の連休位置(前半・中日・後半)を示す特殊連休区分を与え、年ごとの連休ズレを吸収します。
- ② 集客トレンドと店舗属性(ベースラインの形成): 【最重要特徴量】である直近12週の同曜日平均客数を投入。これによりメディア露出や価格改定後の最新ベースラインを捉えます。さらに立地属性や席数を組み合わせます。
- ③ 天候要因(局所的な変動の吸収): 降雨フラグおよび平均気温から、足元の来店ハードル変化を補正します。
- ④ 販促・特定イベント施策(急増ピークの補正): 特定イベント日や独自キャンペーン実施の有無を示す特異日・販促フラグをセットします。
店舗IDを学習させると「店舗Aだから200人」という過学習を起こしやすくなります。あえて除外し、「立地属性 × 席数 × 直近12週平均」という汎用条件で学習させることで、オープン初日の新規店舗でも即座に高精度な予測が出力できる【店舗非依存型モデル】を実現しました。
2. アルゴリズムの選定:説明性と適合性を両立するモデル探求
客数予測に用いる機械学習モデルの選定においては、単に「テストデータで高い精度(低い誤差)が出そうか」という数値上のスペックだけで決めることはできません。実業務へ組み込む上では、「なぜその予測値になったのかを現場や経営陣に論理的に説明できるか(説明可能性)」、および「店舗の増減や新店オープンといった事業成長に耐えられるか(実用性・拡張性)」という複数の条件を高次元で満たす必要があります。
そこで本プロジェクトでは、「高精度」「説明性」「新店対応(汎化性能)」「運用コスト」のバランスを見極めるため、需要予測や時系列解析で一般的に用いられる代表的な4つの手法アプローチ(伝統的時系列モデル、バギング系アンサンブル、深層学習、ブースティング系決定木)を比較対象として選定し、検討を行いました。
| 検討アルゴリズム | 構造的特徴 | 今回の要件(ファストカジュアル)における評価 |
|---|---|---|
| ARIMA (時系列解析モデル) | 店舗ごとの過去時系列データの自己相関・季節性を数式化する伝統的手法。 | 不採用: 店舗ごとに個別のモデル構築が必要となり、新店予測(コールドスタート)が不可能。「立地×天候」のような非線形な相互作用を表現できず、モデル管理コストが膨大になるため。 |
| ランダムフォレスト (アンサンブル学習) | 独立した多数の決定木の予測値を平均化(バギング)する手法。 | 不採用: 予測値が「平均的」に平滑化されやすく、特定イベントの急増や豪雨時の急減といったピークを捉えきれない。分岐時にランダムに特徴量を絞るため、最強特徴量(直近12週平均)を活かしきれない。 |
| DNN (ディープラーニング / 深層学習) | 多層ニューラルネットワークにより複雑なパターンを自動抽出する手法。 | 不採用: 精度は出うるものの、「どの特徴量がどう効いてその予測になったのか」がブラックボックス化しやすく、店舗スタッフや本部への説得力・信頼感に欠けるため。 |
| 勾配ブースティング決定木 ( BOOSTED_TREE_REGRESSOR) | ★ 採用浅い決定木を逐次的に繋ぎ、予測誤差(残差)を順番に補正していく強力な手法。 | 採用: 店舗横断の1つのモデルで全店を予測可能。非線形な条件分岐(「ビジネス街」かつ「雨」なら客数大幅減など)に極めて強く、特徴量重要度(Gain)を用いた説明性も非常に高いため。 |
上記を比較検討した結果、本プロジェクトでは BigQuery ML の勾配ブースティング決定木回帰(BOOSTED_TREE_REGRESSOR) を最終的に採用しました。
なお、学習処理においては時系列順分割(DATA_SPLIT_METHOD = 'SEQ')を指定し、将来のデータが学習に漏れ込む未来バリューのリーク(Data Leakage)を厳格に遮断しています。
-- 決定木モデルの作成(BigQuery ML)
CREATE OR REPLACE MODEL `ai_workspace.model_guest_prediction`
OPTIONS(
  MODEL_TYPE = 'BOOSTED_TREE_REGRESSOR',
  INPUT_LABEL_COLS = ['guest_count'],
  DATA_SPLIT_METHOD = 'SEQ', -- 時系列データのため時系列順に厳密分割
  DATA_SPLIT_COL = 'biz_date'
) AS
SELECT
  * EXCEPT(city_name, store_cd) -- 識別子を除き、汎用特徴量のみを入力
FROM
  `ai_workspace.v_ft_guest_count_daily`
第3章:検証結果と誤差分析(「残差」のビジネス解釈)
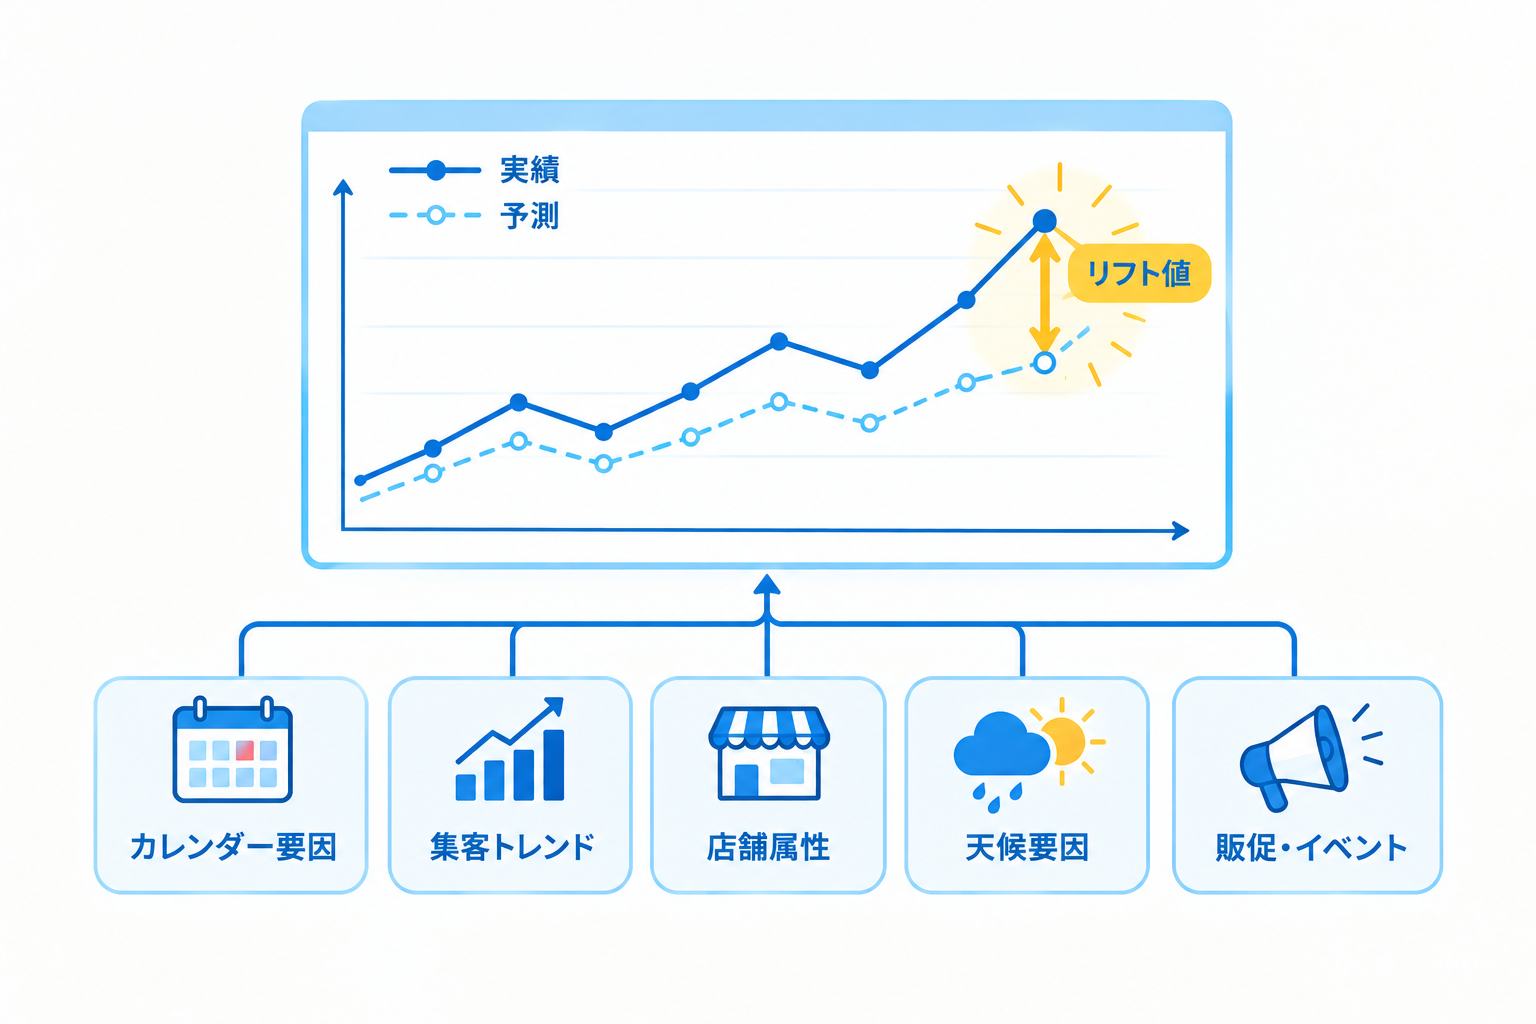
機械学習モデルの評価においては、全体の平均精度が良いことだけに満足せず、特定曜日や立地での極端なズレ、時間経過による精度劣化(Concept Drift)がないかを多角的に検証することが実務運用の肝となります。
1. 全体精度と「特徴量重要度」の解釈
過去の未学習期間(テストデータ)を用いた評価結果は以下の通りです。
- 決定係数(R²): 約 0.86(モデルが客数変動の約86%を説明できていることを示す)
- 平均絶対誤差(MAE): 約 17人 / 日(1日あたりのズレが平均17人程度)
- 平均誤差率(MAPE簡易版): 約 11%(平均客数に対する誤差の割合)
BigQuery MLの ML.FEATURE_IMPORTANCE を用いた内部分析では、寄与度(Gain)の9割以上を avg_12w_weekday_guest_count(直近12週の同曜日平均)が占め、客数のベースラインを一発で決める主役(大黒柱)となっていることが判明しました。一方、気温や雨といった気象情報は決定木の中で何度も分岐(Weightが大きい)し、1〜2人単位の微調整を行う脇役として機能していることが確認できました。
2. セグメント別検証(ブレ・バイアスの確認)
- 立地属性別: 商業繁華エリア(誤差率 約11%)、ビジネス街(約12%)、住宅地(約13%)と、全立地で誤差率は10%前後の狭いレンジに収まり、バイアス(偏り)も最小限に抑えられています。
- 曜日・時系列別: 曜日による精度の偏りはなく、直近1年間の月次推移でもモデルの経年劣化は見られませんでした。
- 天候別(晴れ vs 雨): 通常日(誤差率 約11%)に対し、雨の日(約12%)と同等の安定性を示し、ビジネス街店舗における雨天急減などの複雑な挙動も捉えられています。
3. ドメイン知識に基づく「残差(誤差)」のビジネス解釈
検証工程において、年に一度の大規模キャンペーン日等に実際の客数が大きく上振れ(予測値が下振れ)する現象が確認されました。機械的に専用フラグを追加して過学習させるのではなく、本プロジェクトではあえて専用フラグをつけない判断を下しました。
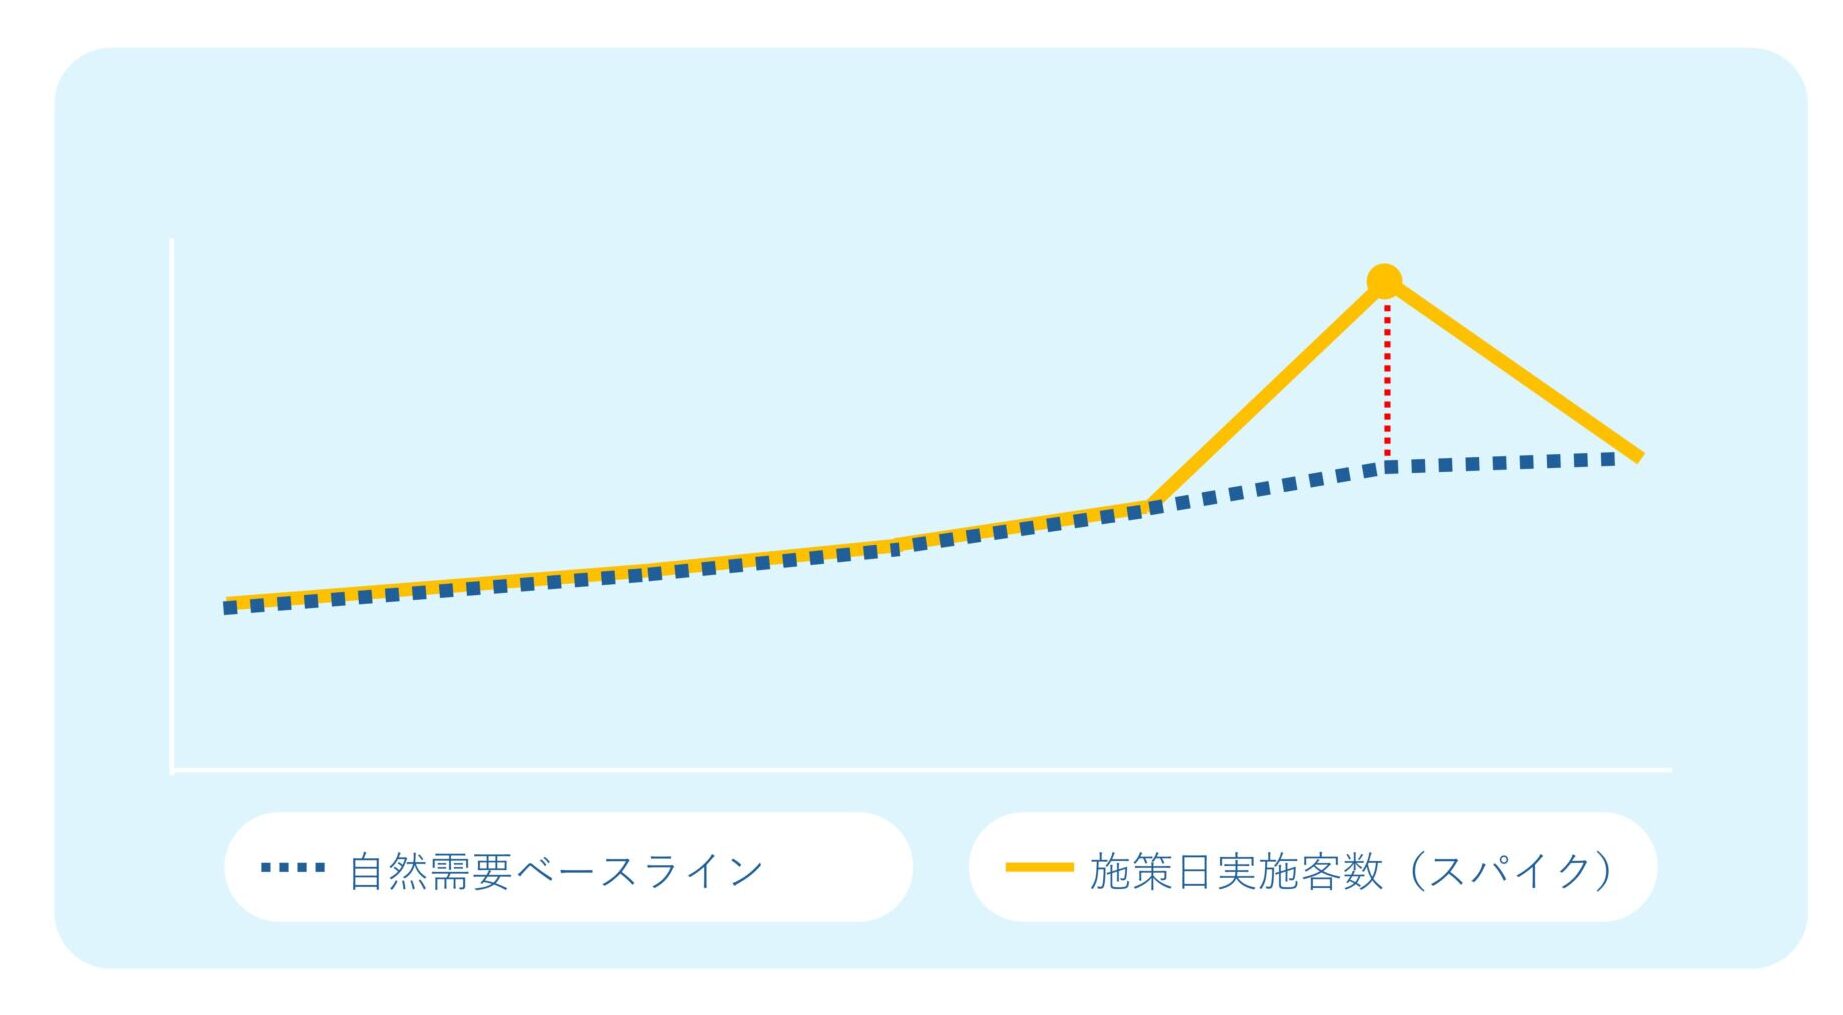
モデルの予測値を「天候や曜日から計算された自然なベースライン」として残しておくことで、実測値との差分(残差)を『施策による真の集客純増効果(リフト値)』として正確に測定・評価できるビジネス運用を確立しました。
第4章:現場と経営をつなぐダッシュボード活用
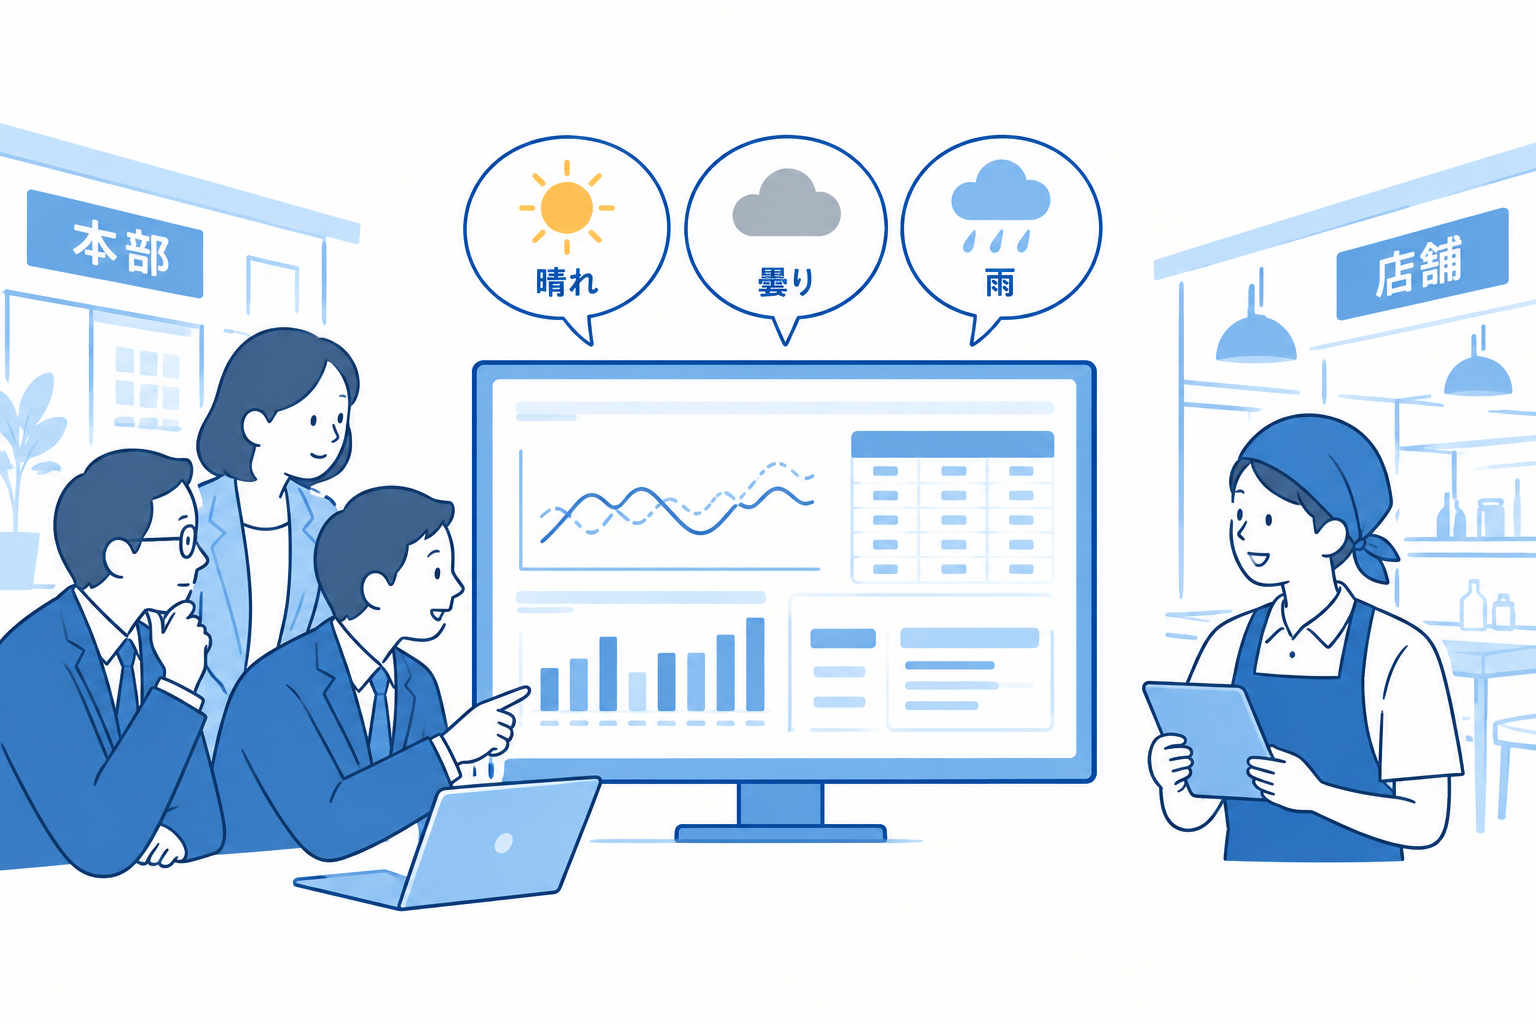
構築した予測パイプラインは自動定期更新化されており、常に最新のPOS実績に基づく過去の予実差分と、今日以降90日先までの未来予測値がデータマートへ格納されます。このデータを、すでに社内で運用されていた既存のBI基盤へ統合しました。
1. 既存のKPI管理ダッシュボードへの統合
本部管理部、事業部長、地区長(SV)が日常的に数値モニタリングで使用している「Looker Studio KPI管理ダッシュボード」内に専用ページとして本モデルを組み込みました。別ツールを立ち上げる手間をなくし、日々の売上・粗利チェックの流れの中で自然に予測値を閲覧できる環境を整えています。
2. 「実績 vs 予測」の可視化による信頼感の醸成
現場の心理的ハードルを払拭するため、第一画面には店舗×日付単位での「実績客数」と「予測客数」の推移グラフおよび比較表を配置しました。過去の客数波形に対する予測値の追従性や誤差率をオープンに示すことで、現場や地区長が納得感を持って数値を扱えるようにしています。
3. 将来90日間の「店舗×日付別」シナリオ予測とデータの再利用
今日以降90日先までの予測値を店舗×日付別で可視化しています。「晴れの場合」と「雨の場合」のダブルシナリオ予測を並記することで、現場の店長は「雨天時の食材ロス回避」と「晴天時のワンオペ事故防止」のリスク幅(レンジ)を把握した上で、バランスの良い仕込み量やシフト配置を判断できます。
さらに、ダッシュボード上の予測データはワンクリックでCSVダウンロードが可能であり、各店舗での独自管理シートへの取り込みや本部での予算シミュレーションへの二次利用・再利用が容易に行えます。
👉飲食店のワークスケジュール【効果的な運営と経営の秘訣】
おわりに:「経験と勘」からデータ主導の店舗運営へ
本記事では、ファストカジュアルチェーンにおける「前年同曜日参照」の限界から、BigQuery MLを活用した汎用需要予測モデルの構築、セグメント別誤差検証、そしてLooker Studioを用いた実務運用への落とし込みまでの一連のプロセスを解説しました。
- 属人化からの脱却: 店長の経験や勘に頼っていた予測業務を標準化し、全店一律で高度な基準値(ベースライン)を自動生成。
- コスト圧縮と利益率改善: 精度向上により、飲食経営の2大課題である「フードロス」と「過剰・不足人件費」を直接的に削減。
- 施策の真のROI評価: モデルの予測値を基準線とすることで、キャンペーンや販促施策による「集客の純増(リフト値)」を定量評価。
クラウドDWHと機械学習技術の発展により、これまで大企業のみに限られていた高度なデータサイエンスのアプローチが、今や実用的なコストとスピードで現場に導入できるようになっています。
単なる「過去集計」にとどまらず、「未来予測」を業務プロセスに組み込むデータ活用について、本事例が皆様のDX推進・店舗運営効率化のヒントとなれば幸いです。